DeepSeek 发布全模态自注意力架构:文字与视听感知深度共融
论文详细阐述了如何在统一 Transformer 架构中平衡不同模态的信息密度差异,有效克服了传统跨模态对齐中的概念遗忘难题。
阅读论文全文 →打破信息形态藩篱。DeepSeek官网 隆重推出多模态原生协同基础大模型,基于同一向量空间将语言逻辑、微观视觉、声学韵律与时序动态影像有机统一,赋予 DeepSeek AI 前所未有的多感官共融认知力。
不再是零散算法拼凑,DeepSeek 从模型架构最底层打通符号、视象、声音与时序动力学
万亿 Tokens 高质量中英代码与学术文献训练,支撑数学公式推导、复杂代码生成与严谨因果推理。
像素级细粒度图像理解,支持 4K 原生图片不缩放分析、几何图表逆向解析及工业微观缺陷标定。
融合自然声学生成与语音多情绪表达,支持双向不间断实时语音对谈与声纹身份自适应校准。
跨秒级动作识别与连续长视频情节推演,能够对体育赛事、安防监控及电影分镜进行秒级叙事解构。
当不同媒介信息产生化学反应,赋能创意生产、科研计算与工业前沿场景
老师上传手写教案,模型自动生成配套图解板书、旁白讲解音频与互动动画。
深度理解电影对话台词、背景音效与人物镜头特写,一键输出精彩高光集锦。
结合文本剧本实时驱动 3D 角色唇形吻合、微表情变换与动态动作姿态同步。
综合患者电子病历、超声音频心音波形与 CT 影像,生成结构化诊断建议报告。
融合座舱乘客手势、视线凝视方向与自然语音指令,精准完成天窗与空调控制。
提供覆盖全场景的多模态模型选型方案,兼顾极速响应与超强推理深度
全模态旗舰旗舰模型,原生集成文字、图视、语音与短视频联合交叉推理。
工业级高清图文理解利器,支持大文档 OCR、工程制图标注与目标框追踪。
实时双工音频模型,自带动态声波可视化接口与拟人化语调合成引擎。
视频与动态时序大模型,专注视频分镜语义索引、长时序行为总结与动作生成。
DeepSeek api开放平台 推出多模态统一请求管道,开发者可以在单个请求 Payload 中自由混编文本提示词、图片 Base64、音频流与视频 URL,由模型自适应分流并协同决策。
在 messages 字段中混合提交 text、image_url、audio_pcm 与 video_clip 模态块。
可自由指定生成目标为文本解答、结构化 JSON、合成语音或生成关键帧图像。
通过 SSE 或 WebSocket 长连接实时接收多模态流,毫秒级在前端卡片渲染交互。
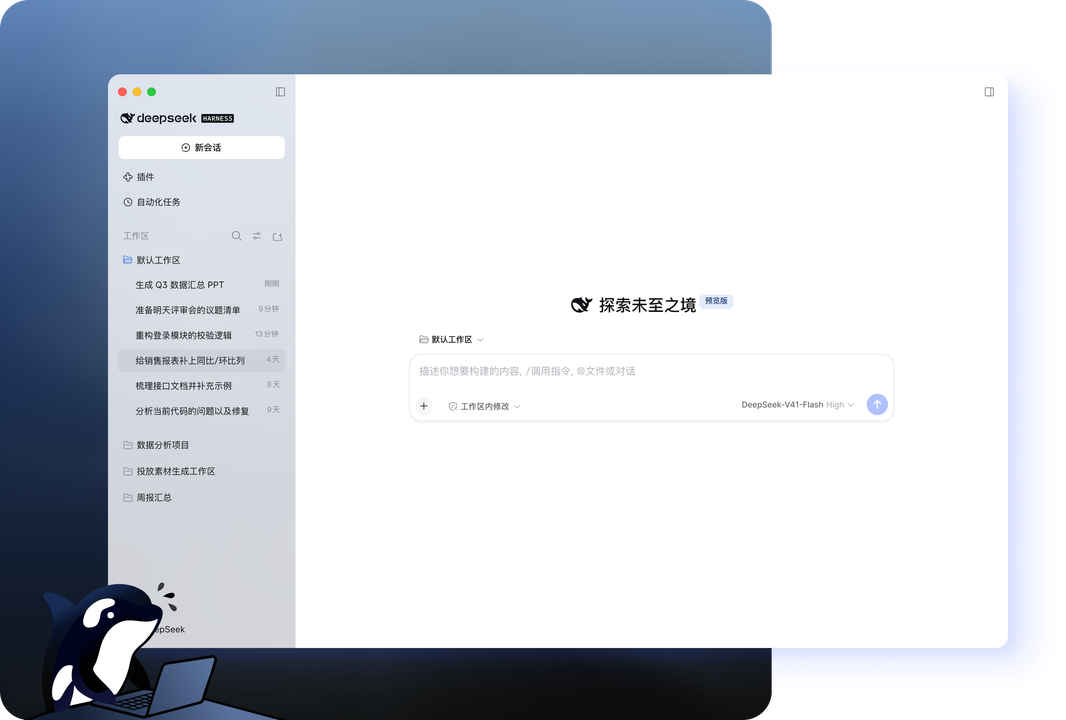
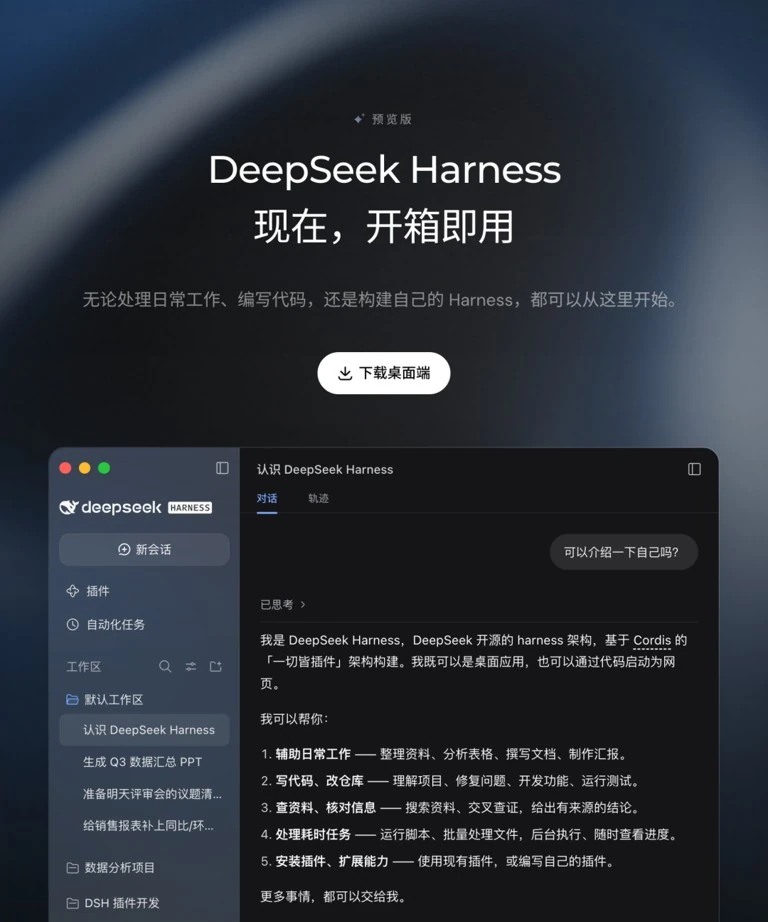
无论在 Windows、Mac、移动设备还是 Linux 工作站,DeepSeek 客户端均深度融合原生系统麦克风、摄像头与剪贴板能力,让文字、图像、音频与视频的交互体验如呼吸般自然顺畅。
关于模型能力边界、跨模态输入格式、费用计费与安全评测的核心解答
跟进 DeepSeek 深度求索在多模态联合预训练、音视频大模型领域的最新科研进展
论文详细阐述了如何在统一 Transformer 架构中平衡不同模态的信息密度差异,有效克服了传统跨模态对齐中的概念遗忘难题。
阅读论文全文 →
为开源社区带来标准化评测管道,无论是图生文逻辑推理还是长视频问答,开发者均可使用标准化命令一键生成评测得分。
查阅 Harness 使用指南 →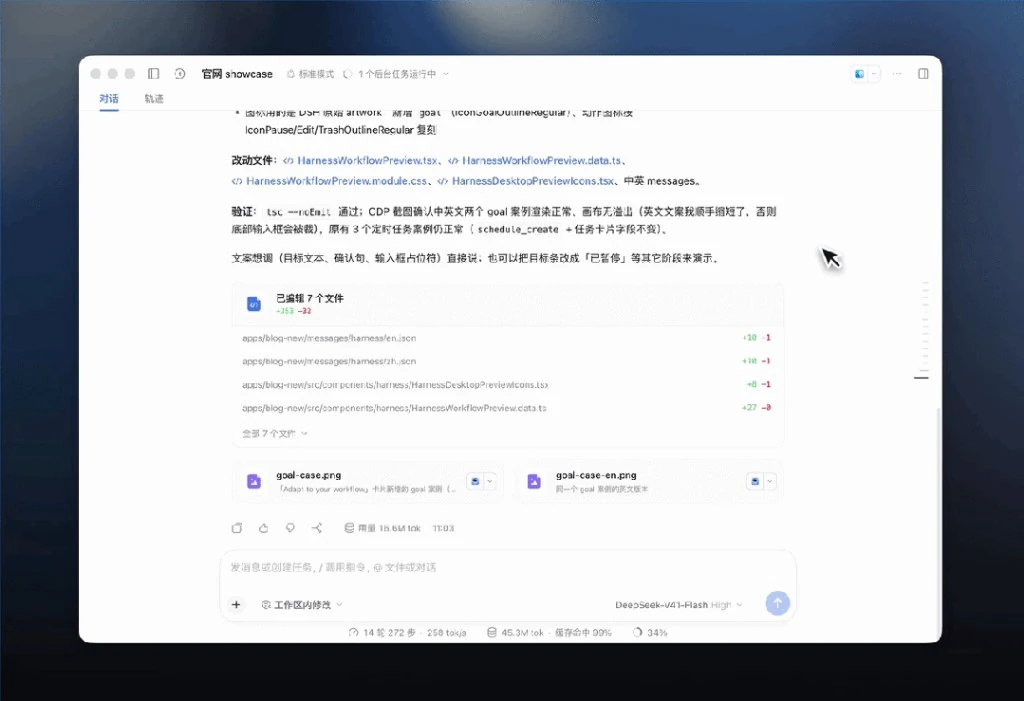
帮助工程制造巨头将数十年积累的技术图纸、巡检录音与产线维修录像快速转化为结构化知识库,知识检索召回率提升 400%。
获取企业解决方案 →